Eigentlich ist es ja ganz einfach: Wir tippen im Browser unserer Wahl eine URL ein und kurze Zeit später öffnet sich eine Seite. Aber was passiert in den Millisekunden, woher kommt die Seite und woher weiß der Browser, was er zeigen soll? Das klären wir heute, Schritt für Schritt, auch verständlich für Menschen, die von Programmieren noch nie etwas gehört haben.
1. Was ist eine Website?
Für eine simple Website kann bereits eine einzelne Datei im html Format ausreichen. Eine html-Datei enthält die Struktur und die Inhalte einer Seite, beispielsweise Textpassagen oder Bilder, und sieht ungefähr so aus:
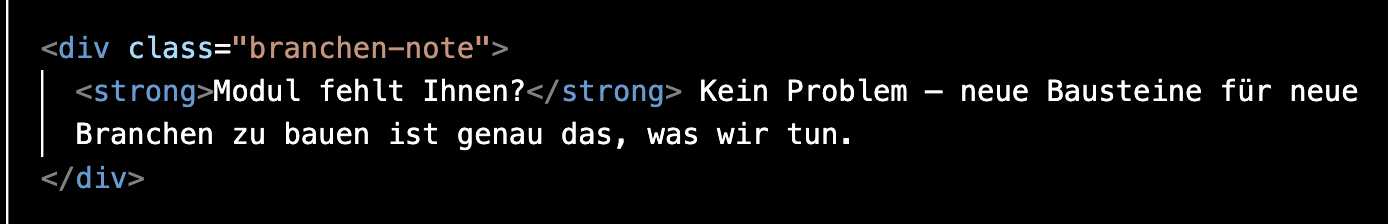
In diesem Beispiel wurde ein Element ("div") mit Text erstellt. Ein Teil des Textes ist fett gedruckt ("strong"), der Rest normal. Auf das "class"-Attribut gehen wir gleich gesondert ein.
Genauso funktioniert es auch mit Bildern, Links und allen möglichen Inhalten. Allerdings enthält html auch nur die Struktur, keine Design- oder Funktionselemente.
Dafür gibt es zwei andere Dateiformate: CSS und JavaScript. CSS ist für das Design einer Seite zuständig. Das fängt bei der Größe und Anordnung von Elementen an und geht über Farben bis zur Darstellung auf unterschiedlichen Bildschirmgrößen und einfachen Animationen. Ein CSS Block sieht beispielsweise so aus:
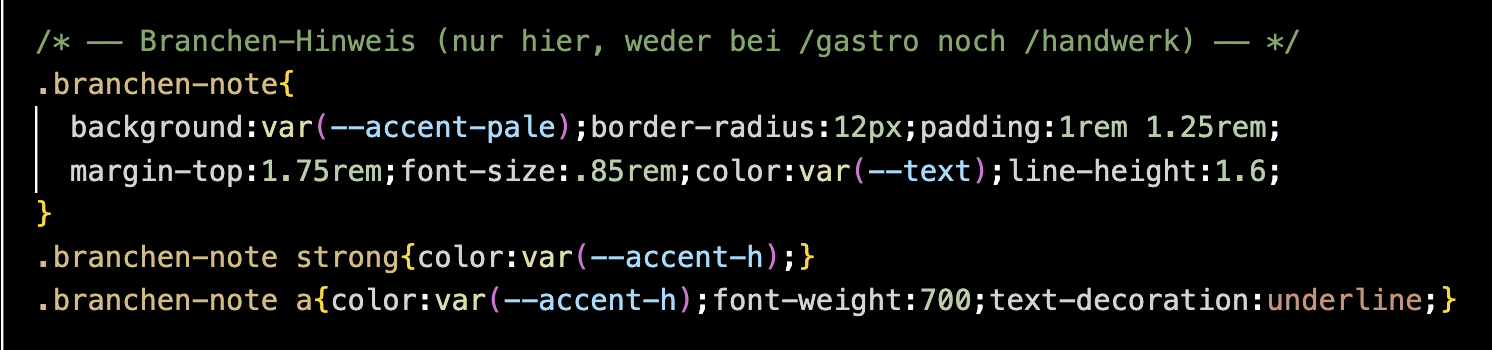
Hier erkennt man auch, wozu das Attribut "branchen-note" im html Block dient: Es sagt dem CSS, was es designen soll. Das coole ist, dass beliebig viele Elemente im html dieselbe Klasse haben können und damit gleich vom CSS gestylt.
Der Beispiel-CSS-Block regelt zunächst die Farbe und die Größe des html-Elements. Außerdem bestimmt es, dass Text, der als "strong" gekennzeichnet wurde, in einer anderen Farbe dargestellt wird und Links ("a") unterstrichen und farblich hervorgehoben werden.
Das dritte Dateiformat ist JavaScript (kurz js). JavaScript kümmert sich vereinfacht gesagt um vieles, was auf einer Website dynamisch passieren soll. Wenn die Website auf einen Knopfdruck reagieren soll, macht das JavaScript. Wenn beim Scrollen etwas passieren soll oder Inhalte dynamisch nachgeladen werden, kommt häufig JavaScript zum Einsatz. JavaScript sieht so aus:
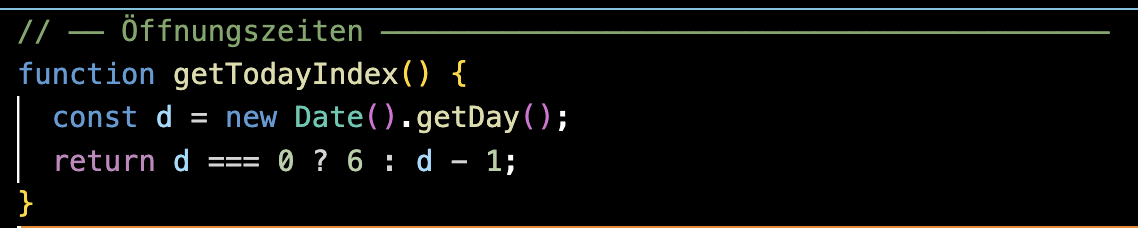
In diesem Beispielblock wird eine Funktion definiert, die bei Aufruf den Wochentag als Zahl (Montag: 0, Sonntag: 6) ausgibt.
"getDay()" liefert den Wochentag als Zahl. Dabei steht normalerweise Sonntag für 0 und Montag für 1. Unsere Funktion rechnet das so um, dass Montag bei 0 beginnt und Sonntag bei 6 endet.
Aus diesen drei Dateitypen kann man eine Website zusammenbauen, entweder als eine große Datei oder als drei kleinere.
2. Was ist eine URL?
Eine URL (Uniform Resource Locator) ist eine Internetadresse, über die sich eine bestimmte Ressource im Internet aufrufen lässt.
Eine URL ist eine Art Wegbeschreibung für einen bestimmten Inhalt. Als Beispiel nehmen wir https://wefa-webdesign.de/agb.
Eine URL besteht aus zwei Teilen, der Domain und dem Pfad. Die Domain ist die Adresse der gesamten Website, beispielsweise wefa-webdesign.de oder wikipedia.org. Alle Unterseiten bauen auf der Domain auf. Der Pfad zeigt dann, welche Seite unter der Domain genau aufgerufen werden soll, beispielsweise "/agb". Beide zusammen ergeben ein eindeutiges Ziel.
Als Bild dargestellt ist die Domain die Adresse eines Hauses und der Pfad der Weg zum richtigen Zimmer.
3. Wie kommt die Seite in den Browser?
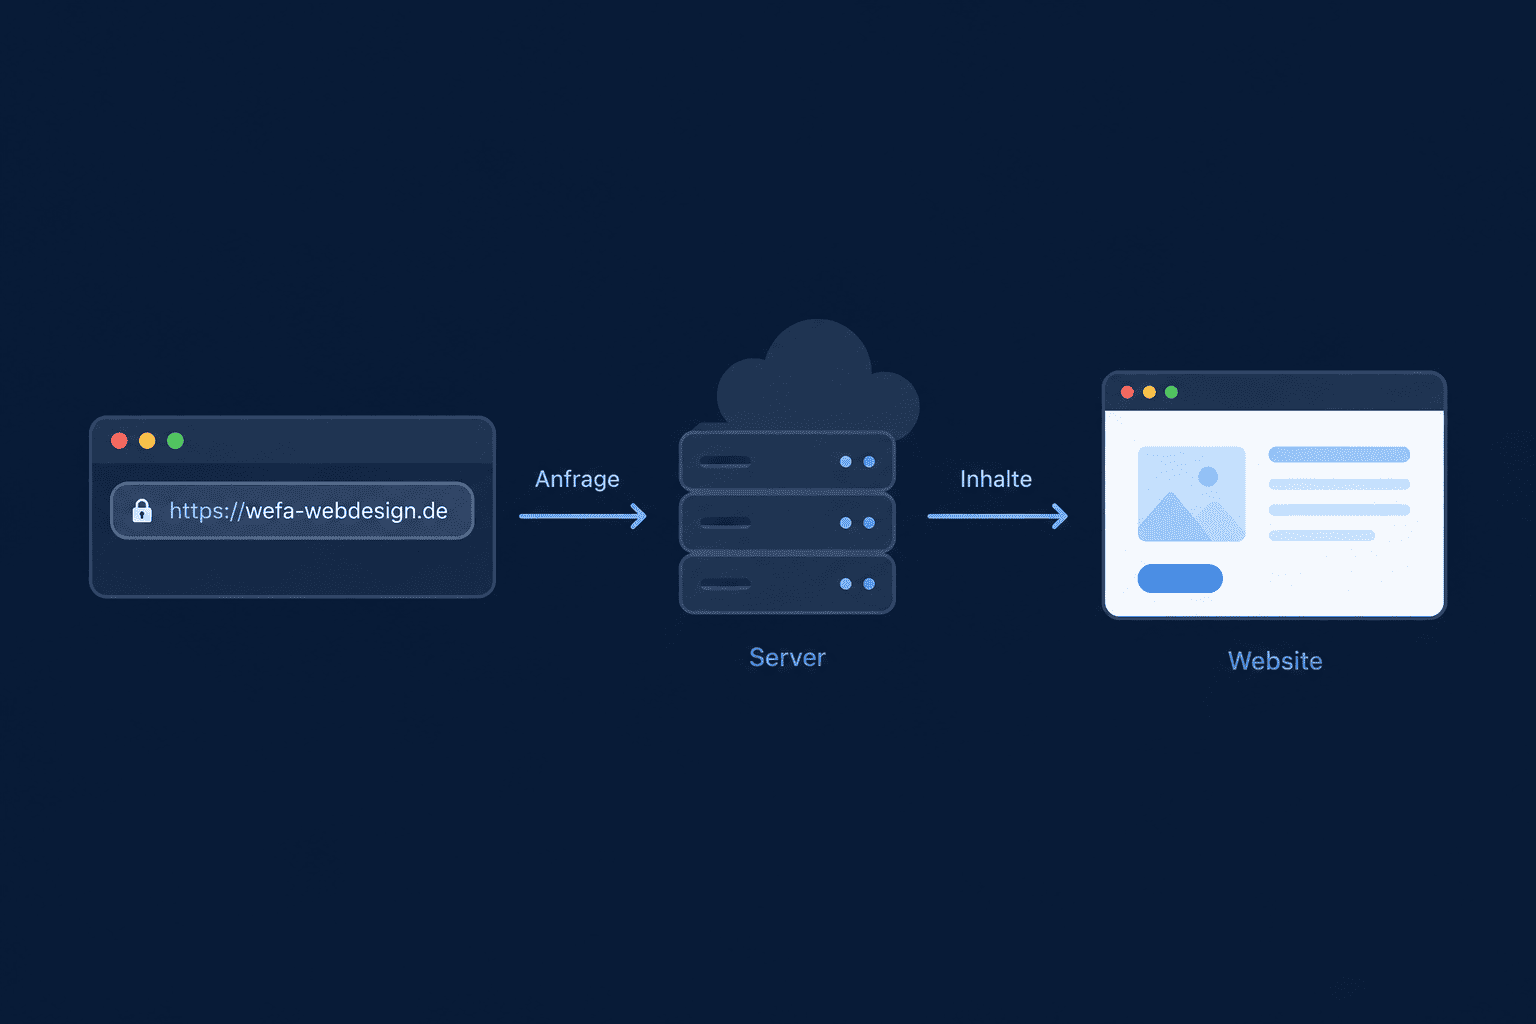
Um zu verstehen, was zwischen der Eingabe einer URL und der Anzeige einer Website passiert, müssen wir uns anschauen, wie der Browser den richtigen Server findet und anschließend die Website von dort abruft.
Wenn eine URL aufgerufen wird, muss der Browser zunächst herausfinden, zu welchem Server die Domain gehört. Dafür wird das sogenannte DNS verwendet. Vereinfacht gesagt funktioniert DNS wie ein Telefonbuch des Internets: Aus wefa-webdesign.de wird eine IP-Adresse, unter der der entsprechende Server erreichbar ist.
Hat der Browser die benötigte IP-Adresse gefunden, kann er eine Verbindung zum entsprechenden Server herstellen und dort die angeforderten Inhalte abrufen. Bei einer einfachen Website können das beispielsweise HTML-, CSS- und JavaScript-Dateien sein.
Der Server verarbeitet die Anfrage und liefert die benötigten Inhalte an den Browser zurück. Bei einer einfachen Website können dabei direkt vorhandene Dateien ausgeliefert werden. Bei komplexeren Websites können die Inhalte auch erst auf dem Server erzeugt werden. Wie das genau funktioniert, werden wir in einem anderen Post klären – das wäre hier zu viel.
Hat der Browser die benötigten Inhalte erhalten, verarbeitet er das HTML und baut daraus die Seite auf. Verweist das HTML beispielsweise auf CSS- oder JavaScript-Dateien, lädt der Browser diese ebenfalls und verarbeitet sie. Das CSS bestimmt dabei unter anderem die Darstellung, während JavaScript zusätzliche Funktionen und Interaktionen ermöglicht.
Vereinfacht sieht der Ablauf also so aus:
URL → DNS → Server → Inhalte → Browser → fertige Website
Fazit
Wenn wir eine Website aufrufen, passiert also deutlich mehr, als es auf den ersten Blick scheint. Die URL gibt vor, welchen Inhalt wir aufrufen möchten, DNS hilft dem Browser dabei, den richtigen Server zu finden, und der Server liefert die benötigten Inhalte zurück. Der Browser verarbeitet diese anschließend und macht daraus die Website, die wir sehen.
Und obwohl wir im Alltag nur eine Adresse eingeben und eine fertige Seite sehen, steht dahinter ein Zusammenspiel aus vielen einzelnen Bausteinen.
Was genau auf dem Server passiert und warum manche Websites Inhalte erst beim Aufruf erzeugen, schauen wir uns in einem späteren Beitrag genauer an.